Ingesta de Documentos — Knowledge Base RAG
Pipeline de ingesta multi-fuente que convierte documentos en una base de conocimiento consultable por agentes de IA.
Problema
Un agente con RAG solo es tan bueno como su base de conocimiento — y esa base casi nunca vive en un solo lugar: hay PDFs internos, páginas web, y datos que salen de APIs de terceros. Sin un pipeline de ingesta ordenado, cada fuente nueva termina siendo un script suelto y el contexto que recibe el agente es inconsistente o queda desactualizado.
Solución
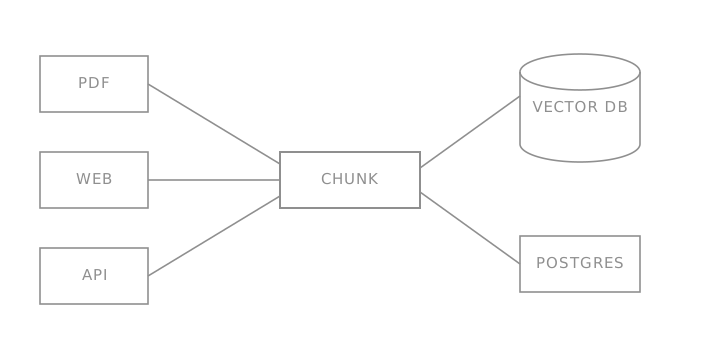
Pipeline de ingesta que conecta múltiples fuentes (documentos PDF, contenido web, APIs), normaliza el texto y lo divide en chunks con solapamiento controlado para no cortar ideas a la mitad. Los embeddings se indexan en Pinecone o en el stack de AWS (OpenSearch / Bedrock Knowledge Bases) según el caso, mientras PostgreSQL guarda la metadata estructurada de cada documento — origen, versión, estado de procesamiento — para poder reprocesar o invalidar contexto sin reconstruir todo el índice. El resultado es la base de conocimiento que consultan mis agentes RAG.
Stack y arquitectura
- Chunking con tamaño y solapamiento configurables por tipo de fuente, para no romper párrafos o bloques de código a la mitad.
- Pinecone como base vectorial principal, con la opción de indexar en AWS (OpenSearch Serverless / Bedrock Knowledge Bases) cuando el proyecto ya vive en ese ecosistema.
- PostgreSQL para metadata estructurada: qué documento vino de dónde, cuándo se procesó, y su estado — separado del vector store para poder auditar y reprocesar sin tocar los embeddings.
- LangChain para los loaders de cada tipo de fuente y para el paso de embedding, con normalización de texto previa al chunking.
- Pensado para correr como job programado o disparado por evento, así el conocimiento del agente se actualiza sin intervención manual.
Retos
Balancear el tamaño del chunk: piezas muy pequeñas pierden contexto, piezas muy grandes diluyen la relevancia en la búsqueda por similitud. El otro reto fue separar claramente qué vive en el vector store (embeddings para búsqueda semántica) de qué vive en PostgreSQL (metadata estructurada y control de versiones), para que reprocesar una fuente no signifique reconstruir todo el índice desde cero.